هل المشكلة دايمًا في الـ Model؟
لو بتستخدم AI Coding Agents زي Claude Code أو Codex أو OpenHands في شغلك، غالبًا قابلتك مواقف شبه دي.
بتدي الـ Agent مهمة واضحة، زي إنه يصلّح Bug في مشروع، فيبدأ يقرأ ملفات كتير، ويعمل Tool Calls ملهاش لازمة، وممكن يعدّل في أماكن مش مرتبطة بالمشكلة أصلًا.
وفي الآخر، يا إما يوصل لحل مش دقيق، يا إما يستهلك وقت وTokens أكتر من المطلوب.
أول حاجة ممكن نفكر فيها إننا نغيّر الـ Model ونستخدم واحد أقوى.
بس هل المشكلة فعلًا في قدرات الـ Model؟ ولا في الطريقة اللي إحنا مجهزينه بيها علشان يشتغل؟
السؤال ده هو نقطة البداية لفكرة مهمة في عالم الـ AI Agents، واللي بيحاول بحث جديد من Google Research يجاوب عليها.
البحث اسمه Harness²: Recursive Agent Harnessing for an Open World.
الفكرة الأساسية إننا بدل ما نحاول نحسّن الـ Model نفسه، نقدر نحسّن النظام اللي حواليه، ونخلي النظام ده يتعلم من تجاربه السابقة علشان يعرف يطوّر نفسه مع كل مهمة جديدة.
لكن علشان نفهم البحث، محتاجين الأول نفهم شوية مفاهيم أساسية.
أولًا: إيه الفرق بين الـ AI Model والـ AI Agent؟
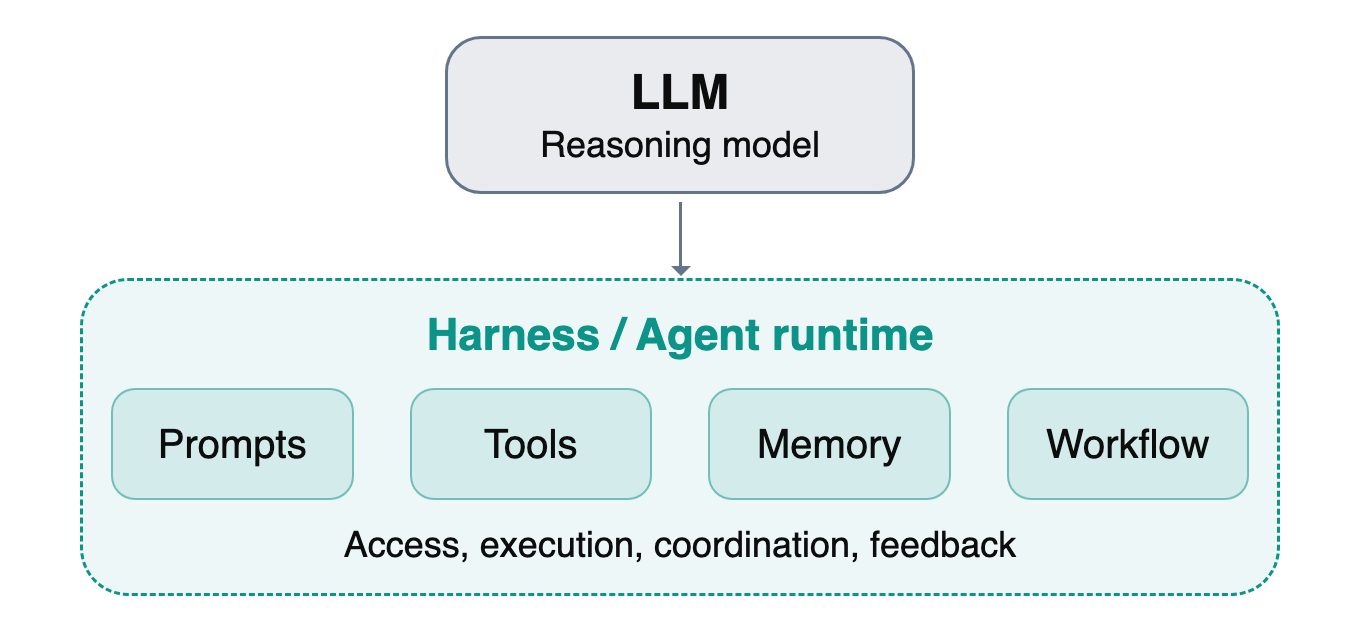
الـ Large Language Model (LLM) هو الـ Model المسؤول عن معالجة المعلومات وتوليد الردود والأكواد واتخاذ قرارات بناءً على الـ Context اللي بيستقبله.
لكن الـ Model لوحده مش بالضرورة عنده القدرة إنه يفتح ملفات، يشغّل Commands، يستخدم Browser، أو يتعامل مع GitHub.
علشان نستخدمه في تنفيذ مهام حقيقية، بنضيف حواليه نظام بيوفرله الأدوات والصلاحيات والتعليمات اللي محتاجها.
وده اللي بنسميه Agent Harness.
تقدر تتخيل إن الـ Model هو العقل المسؤول عن التفكير واتخاذ القرارات، والـ Harness هو بيئة العمل اللي بتساعده يحوّل القرارات دي لأفعال.
الـ Harness ممكن يشمل:
| Component | وظيفته |
|---|---|
| System Prompt | التعليمات الأساسية اللي بتحدد سلوك الـ Agent |
| Guardrails | القواعد والحدود اللي المفروض يلتزم بيها |
| Memory | المعلومات والخبرات اللي بيحتفظ بيها |
| Skills | إجراءات وتعليمات متخصصة لمهام معينة |
| Tool Guidance | إرشادات استخدام الأدوات المختلفة |
| Scripts | أكواد جاهزة لتنفيذ عمليات محددة |
| Subagents | Agents فرعيين لتنفيذ مهام متخصصة |
| Plugins | إضافات بتتحكم في أجزاء من الـ Runtime |
خلينا نفترض إن عندنا Agent بيشتغل على تطبيق ويب بيتعامل مع قاعدة بيانات.
لو الـ Agent مش عارف ينفذ استعلامات SQL بشكل صحيح، ممكن نضيفله Skill بتشرحله طريقة قراءة الـ Database Schema وكتابة الاستعلامات بأمان.
ولو بيبدأ يعدّل في الكود قبل ما يفهم المشكلة، ممكن نحسّن الـ System Prompt أو نضيف Guardrail يطلب منه يجمع أدلة ويحدد سبب المشكلة قبل التعديل.
ولو بينسى قرارات مهمة في Architecture المشروع، ممكن نحسّن طريقة إدارة الـ Memory.
كل دي تغييرات ممكن تحسّن أداء الـ Agent، من غير ما نغيّر الـ LLM نفسه.
وده أول مفهوم مهم في البحث:
قدرات الـ AI Agent مش بتعتمد على قوة الـ Model بس، لكن كمان على جودة الـ Harness اللي شغال من خلاله.
طيب يعني إيه Harnessing؟
ببساطة، Harnessing هي عملية تحسين الـ Harness نفسه.
إحنا بنراجع أداء الـ Agent، ونحدد المشاكل اللي بتواجهه، ونغيّر التعليمات أو الأدوات أو الـ Workflow علشان نقلّل المشاكل دي.
مثلًا، لو عندك Agent بيشتغل على مشاريع React، ولاحظت إنه بيكتب الكود من غير ما يشغّل Tests، ممكن تضيفله تعليمات تطلب منه تشغيل الاختبارات المناسبة بعد أي تعديل.
لكن هنا بيظهر سؤال تاني:
ليه إحنا اللي لازم نكتشف المشاكل ونحسّن الـ Harness يدويًا؟
هل ممكن الـ Agent نفسه يراقب أداءه، ويقترح تحسينات، ويجرّبها، ويتعلم منها؟
وهنا بنوصل للفكرة الأساسية في Harness².
Recursive Self-Improvement: لما النظام يتعلم إزاي يحسّن نفسه
مصطلح Recursive Self-Improvement (RSI) معناه إن النظام بيقدر يعمل تحسينات في نفسه، والتحسينات دي تأثر على الطريقة اللي هيستخدمها علشان يعمل تحسينات تانية بعد كده.
خلينا نفرّق بين حالتين.
الحالة الأولى: Improvement عادي
عندك Agent مطلوب منه يصلّح Bug.
- يحاول يحل المشكلة.
- يكتشف إن الحل مش شغال.
- يجرّب طريقة تانية.
- ينجح في النهاية.
ده نوع من الـ Iterative Improvement، لكنه مش بالضرورة معناه إن النظام نفسه اتطوّر.
ممكن لما يواجه Bug مشابه بعد أسبوع، يكرر نفس الأخطاء من الأول.
الحالة التانية: Recursive Improvement
الـ Agent يحاول يحل المشكلة، ويلاحظ إنه قضى وقت طويل بيعدّل في الـ Frontend قبل ما يتأكد إن المشكلة مش جاية من الـ Backend.
بدل ما يكتفي بإصلاح الـ Bug، النظام يحتفظ بالدرس ده، ويستخدمه لتحسين طريقة التعامل مع المشاكل المشابهة مستقبلًا.
ومع الوقت، ممكن يتعلم كمان إزاي يحدد أي نوع من التحسينات مفيد وأي نوع مش بيجيب نتيجة.
هنا إحنا مش بنحسّن أداء مهمة واحدة بس.
إحنا بنحسّن عملية التحسين نفسها.
وده سبب تسمية المشروع Harness².
الفكرة مش إن الـ Model بيعيد تدريب نفسه أو بيغيّر الـ Weights بتاعته. بالعكس، البحث بيحتفظ بالـ Model Weights ثابتة، وبيشتغل على تحسين النظام المحيط بالـ Model.
المشكلة الأصعب: إزاي نعرف إن التحسين فعلًا أفضل؟
في Software Engineering، إحنا متعودين إننا نستخدم Tests علشان نعرف إذا كان الكود صحيح.
مثلًا:
expect(calculateTotal([100, 50])).toBe(150);عندنا Input وExpected Output، وبالتالي نقدر نحدد هل النتيجة صحيحة ولا لأ.
لكن تخيل إنك طلبت من Agent يعمل Architecture Proposal لنظام جديد.
أو يحلل مشكلة Performance.
أو يكتب Technical Documentation لمشروع كبير.
إزاي نعرف إن النتيجة الجديدة أفضل من القديمة؟
ممكن ميكونش فيه إجابة واحدة صحيحة، أو Test يقدر يحكم على جودة الناتج بشكل كامل.
وده اللي الباحثين بيسموه غياب الـ Ground-Truth Feedback.
يعني معندناش مرجع مضمون نقدر نقارن بيه النتيجة ونقول إنها صحيحة 100%.
الحل اللي بيستخدمه Harness² هو Contrastive Feedback.
بدل ما نعتمد فقط على معرفة الإجابة الصحيحة، بنقارن سلوك الـ Agent قبل وبعد التعديلات.
مثلًا:
| Before | After |
|---|---|
| الـ Agent بيقترح Tests لكن مش بيشغّلها | بدأ يشغّل Tests فعلية |
| بيعدّل في الكود من غير ما يحدد سبب المشكلة | بيجمع Evidence قبل التعديل |
| بيكرّر نفس Tool Calls الفاشلة | غيّر طريقة استخدام الأدوات |
| مش بيطلع الملفات المطلوبة | بدأ ينتج الـ Deliverables المطلوبة |
المقارنة دي بتدينا معلومات مهمة عن تأثير التحسين.
لكن لازم نفرّق بين حاجتين: إن سلوك الـ Agent اتحسّن، وإن الناتج النهائي أصبح صحيحًا.
الأولى ممكن نلاحظها من الـ Execution Logs، لكن التانية أحيانًا بتحتاج Evaluation مستقلة.
والبحث نفسه بيعترف بالنقطة دي.
إزاي Harness² بيشتغل فعلًا؟
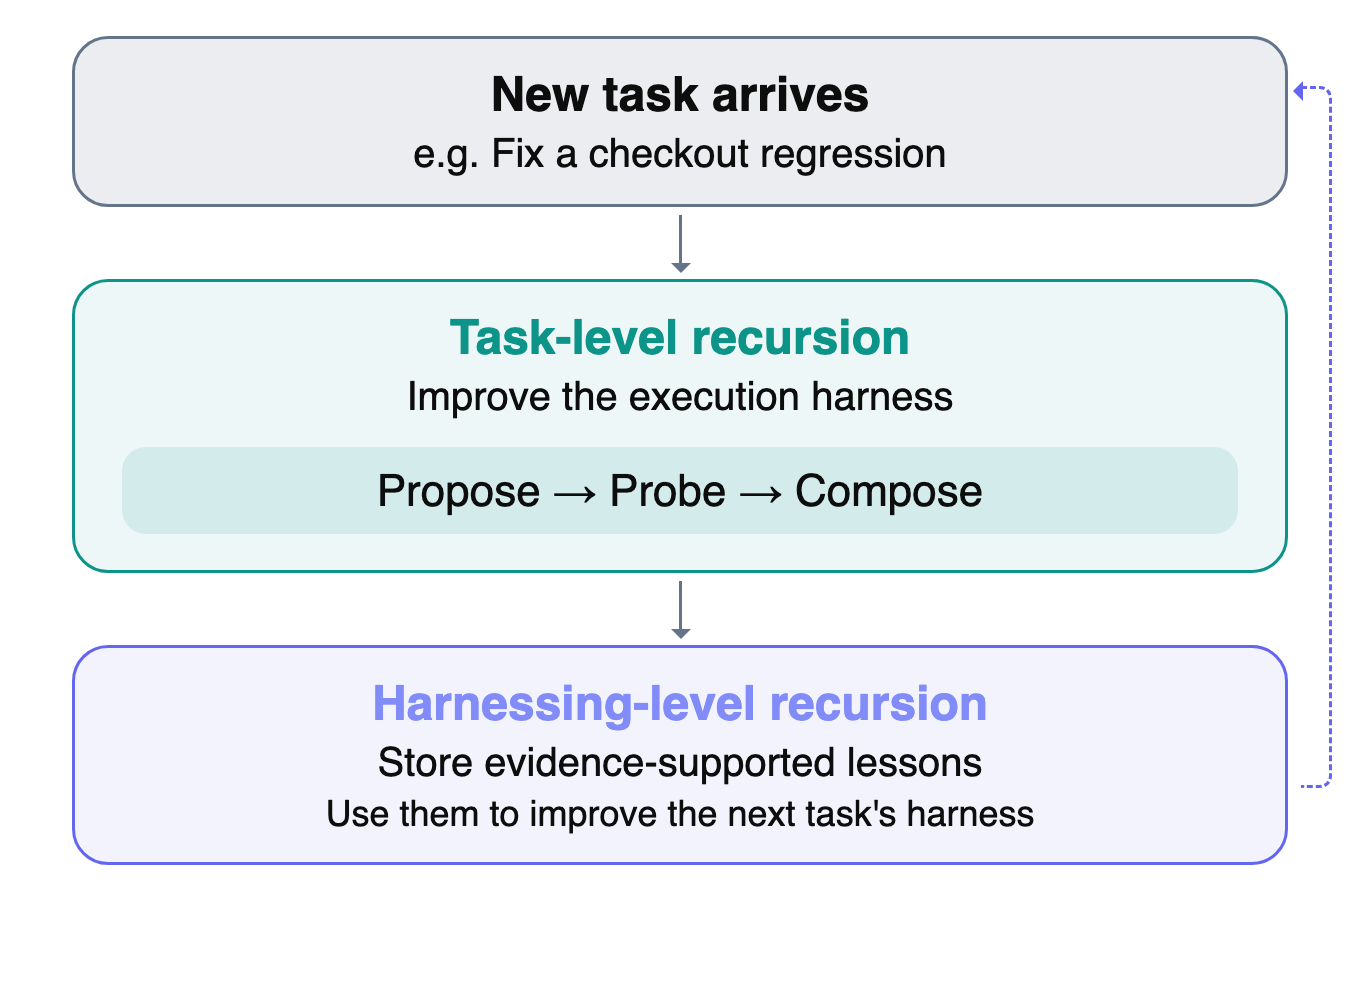
النظام عنده مستويين مختلفين من التحسين:
1. Task-Level Recursion
تحسين الـ Execution Harness علشان ينفّذ المهمة الحالية بشكل أفضل.
2. Harnessing-Level Recursion
الاحتفاظ بالتحسينات والدروس المستفادة، واستخدامها علشان تحسين الـ Harness يبقى أذكى في المهام المستقبلية.
خلينا نفهم كل مستوى.
المستوى الأول: Task-Level Recursion
البحث بيستخدم عملية اسمها:
Propose → Probe → Compose
وهي تقريبًا قلب النظام.
1. Propose — اقتراح التحسينات
في البداية، النظام بيشغّل الـ Agent بالـ Harness الأصلي، ويسجّل اللي حصل.
مش بس النتيجة النهائية، لكن كمان الـ Execution Trajectory.
الـ Trajectory هو سجل الخطوات اللي الـ Agent نفّذها: الأدوات اللي استخدمها، الأوامر اللي شغّلها، النتائج اللي رجعتله، والقرارات اللي اتخذها.
بعد كده، النظام بيحلل السلوك ده، ويقترح تعديلات على الـ Harness.
التعديلات بتنقسم لنوعين:
Invariant Improvements
دي تحسينات عامة ممكن تفيد في مجالات مختلفة، زي تحسين التخطيط، إدارة الـ Context، أو استخدام الأدوات.
Domain-Specific Improvements
دي تحسينات مرتبطة بمجال أو بيئة معينة.
زي إن Agent شغال على WordPress محتاج يفهم الـ Plugins وDatabase Schema، بينما Agent تاني شغال على Kubernetes محتاج يفهم Pods وDeployments وServices.
الفصل بين النوعين مهم، لأن مش كل مشكلة بتحتاج تعديل عام في سلوك الـ Agent. أحيانًا المشكلة ببساطة إنه ناقصه معرفة متخصصة.
2. Probe — تجربة التحسينات
بدل ما النظام يقبل أي تعديل لمجرد إنه يبدو منطقي، بيجرّبه.
بيشغّل نفس المهمة باستخدام الـ Candidate Harnesses المختلفة، ويقارن الـ Execution Trajectories والنتائج.
مثلًا، ممكن يختبر نسخة محسّنة في الـ System Prompt، ونسخة تانية فيها Skill متخصصة.
وبعد كده يشوف كل نسخة غيّرت إيه في السلوك.
دي نقطة مهمة لأننا كمطورين بنعمل حاجة مشابهة طول الوقت.
بنقترح تغيير، نجرّبه، نراقب تأثيره، وبعدين نقرر إذا كان يستحق الاعتماد.
الفرق هنا إن النظام بيحاول يعمل العملية دي بشكل آلي.
3. Compose — تجميع أفضل التحسينات
بعد التجارب، الـ Composer بيحلل الاختلافات بين النتائج.
ممكن يختار Candidate معين، أو يجمع تعديلات متوافقة من أكتر من Candidate، أو يراجع بعض التعديلات، أو حتى يحتفظ بالـ Harness الأصلي لو الأدلة مش كافية.
وبعدها بيشغّل المهمة باستخدام الـ Refined Harness.
المهم هنا إن الهدف مش مجرد اختيار إجابة شكلها أفضل، لكن بناء Harness أحسن بناءً على التغييرات اللي ظهرت في سلوك الـ Agent.
Parallel vs Sequential Recursion
البحث بيدعم طريقتين لتكرار عملية التحسين.
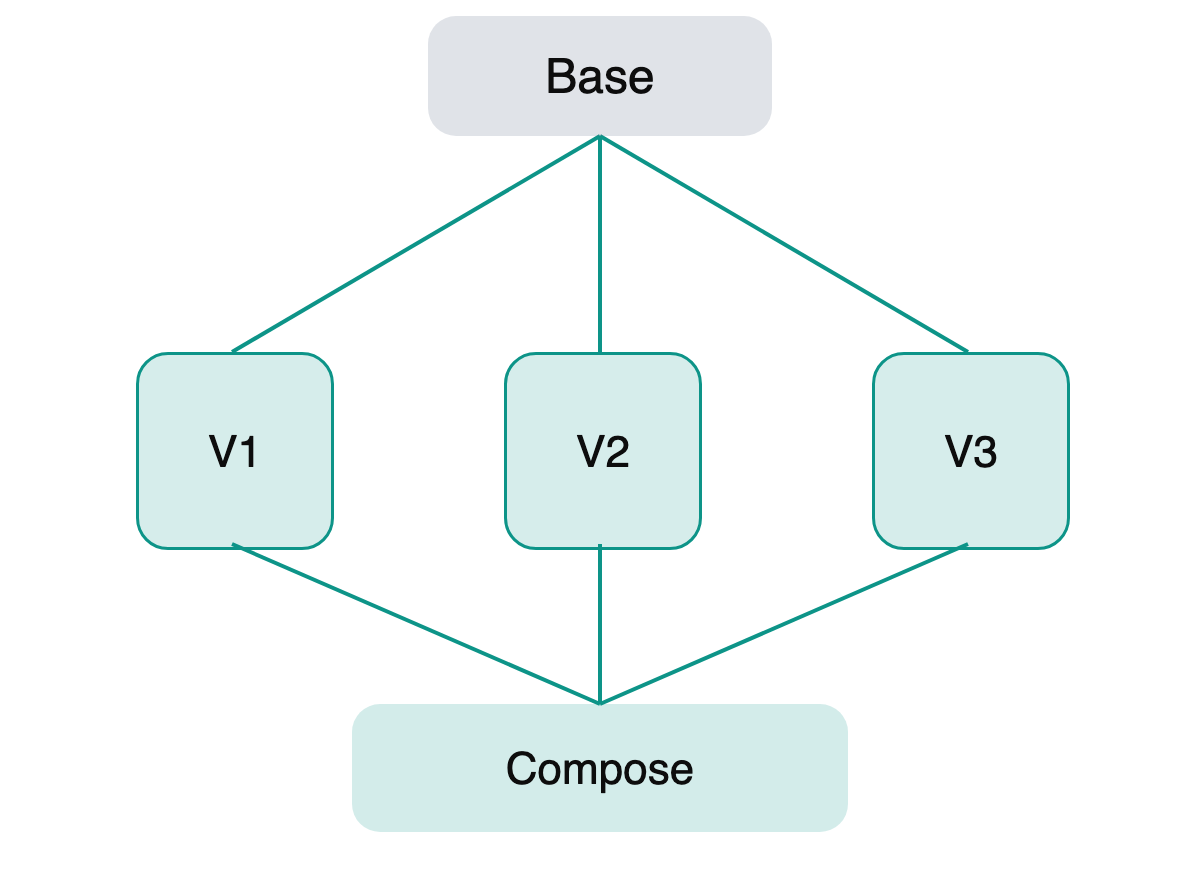
Parallel Recursion
النظام بيجرّب مجموعة من الـ Candidate Harnesses انطلاقًا من نفس الـ Base Harness، ويقارن نتائجهم.
دي مناسبة لاستكشاف حلول مختلفة.
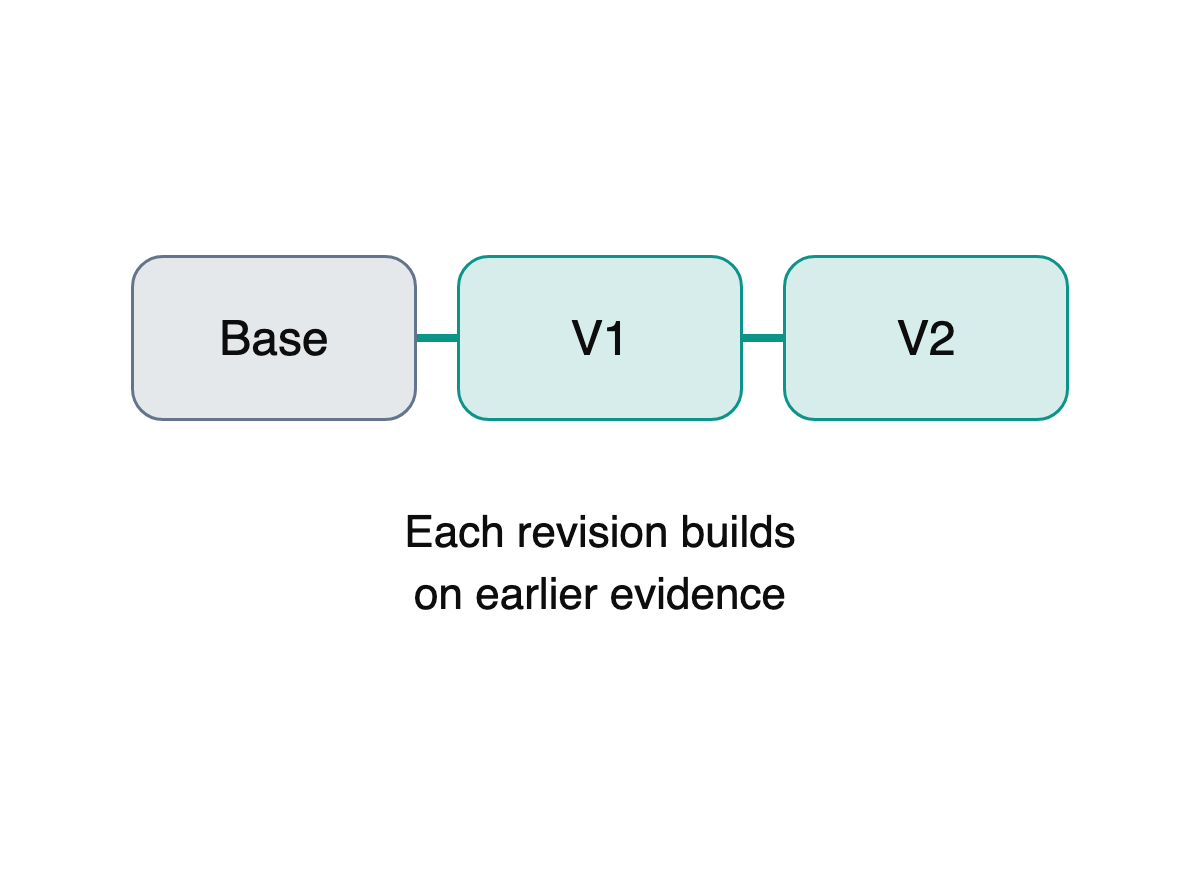
Sequential Recursion
النظام بيبدأ بتحسين، وبعدها يستخدم الـ Refined Harness الناتج مع الأدلة المتراكمة علشان يعمل تحسين جديد، وهكذا.
دي مناسبة للتحسين التدريجي على مراحل.
عدد محاولات التحسين بيتحكم فيه Parameter اسمه k.
لكن زيادة k معناها كمان تكلفة أعلى، لأننا بنشغّل الـ Agent مرات أكتر وبنستهلك Tokens وCompute إضافي.
والبحث بيوضح إن زيادة المحاولات ممكن تحسّن الأداء، لكنها مش ضمان إن كل محاولة هتكون أفضل من اللي قبلها.
المستوى التاني: Harnessing-Level Recursion
وده بالنسبة لي الجزء الأكثر إثارة للاهتمام في البحث.
بعد ما النظام يخلّص المهمة، مش بيكتفي بالـ Refined Harness اللي وصل له.
بيبدأ يعمل Experience Reflection.
يعني بيراجع التجربة ويحاول يفهم:
- إيه المشكلة اللي كانت موجودة؟
- إيه التعديل اللي عمل فرق في السلوك؟
- إيه الـ Evidence اللي بيدعم إن التعديل مفيد؟
- إمتى ممكن نستفيد من التحسين ده في مهمة تانية؟
وبعد كده بيحتفظ بالـ Adopted Harness والدروس المستفادة داخل Experience Library.
البحث بيستخدم ملفات زي EXPERIENCE.md علشان يوثّق التجارب دي.
ولما تيجي مهمة جديدة، النظام يقدر يرجع للخبرات السابقة ويستخدم المناسب منها في تصميم تحسينات جديدة.
ودي نقطة مختلفة عن إننا نحفظ شوية Prompts ونستخدمهم تاني.
إحنا هنا بنحتفظ بمعلومات عن ليه التحسين اشتغل، وإمتى ممكن يشتغل تاني.
لكن مهم نفهم إن النظام مش بينقل آخر Harness ناجح لكل المهام بشكل أعمى.
لأن Harness مناسب لتحليل مشكلة في Database ممكن ميكونش مناسب تمامًا لتطوير React Component.
الهدف هو إعادة استخدام الخبرة المناسبة للسياق الجديد.
مثال عملي: AI Agent بيشتغل على متجر إلكتروني
خلينا نطبّق الفكرة على سيناريو قريب من شغلنا كمطوّرين.
المثال ده توضيحي مني، مش تجربة منشورة في البحث.
افترض إن عندنا متجر إلكتروني مبني بـ Next.js، وبيسحب بيانات المنتجات من Headless CMS، وفيه CDN Cache وBuild Pipeline مسؤولين عن تحديث الموقع.
العميل بيبلغنا إن تعديل سعر منتج في الـ CMS مش ظاهر على الموقع.
بنطلب من الـ AI Agent يحقق في المشكلة.
المحاولة الأولى
الـ Agent يبدأ يقرأ React Components، ويشك إن المشكلة في الـ Frontend Cache.
وبعد شوية يغيّر Component معين، لكن المشكلة تفضل موجودة.
لو عندنا Harness²، هنقدر نستخدم الـ Execution Trajectory علشان نفهم مسار التحقيق.
اقتراح التحسينات
النظام ممكن يقترح تحسين عام:
قبل تعديل الكود، لازم الـ Agent يحدد مصدر المشكلة ويجمع أدلة تدعم فرضيته.
ويقترح تحسين متخصص:
عند التحقيق في مشكلة Stale Content، افحص البيانات في الـ CMS API، وبعدها الـ Build Process، وبعدها الـ CDN Cache.
تجربة التحسينات
النظام بيجرّب كل Candidate على نفس المهمة.
ممكن نكتشف إن التحسين العام خلّى الـ Agent يجمع أدلة أفضل.
والتحسين المتخصص خلّاه يفهم الـ Data Flow ويكتشف إن الـ Fast Build مش بيحدّث الـ Node المطلوب.
تجميع التحسينات
الـ Composer ممكن يجمع التحسينين في Harness واحد.
وبعد ما يخلص، الـ Experience Reflector يسجّل درس مهم:
لما تشتغل على مشكلة Stale Content في نظام مكوّن من عدة مراحل، افحص كل مرحلة في الـ Data Pipeline وحدد المكان اللي التغيير بيقف عنده، قبل ما تبدأ تعدّل في الـ Presentation Layer.
الدرس ده مش مرتبط بـ Next.js أو الـ CMS ده بس.
ممكن يكون مفيد مع Next.js أو أنظمة فيها CDN وCaching وEvent-Driven Pipelines.
وده جوهر الفكرة: النظام مش بس بيحل المشكلة، لكنه بيحاول يطوّر طريقة التعامل مع المشاكل المشابهة مستقبلًا.
طيب هل البحث أثبت إن الفكرة ناجحة؟
الباحثون جرّبوا Harness² على ثلاث Benchmarks مختلفة:
- WorkBuddy-Bench: مهام مرتبطة بالـ Coding والويب والأعمال المكتبية.
- JobBench: مهام مهنية متعددة الخطوات.
- LAB (Legal Agent Benchmark): مهام مرتبطة بالمجال القانوني.
وتم اختبار النظام باستخدام أكثر من Model وExecutor Configuration.
النتائج المنشورة بتوضح تحسن في الأداء بعد خطوة واحدة من Harness².
| Benchmark | أكبر تحسن منشور |
|---|---|
| WorkBuddy-Bench | +11.5 Score Points |
| JobBench | +4.5 Score Points |
| LAB | +11.8 Percentage Points في Partial Pass Rate |
الأرقام دي مش معناها إن أي Agent هنضيفله Harness² هيتحسن بنفس المقدار.
دي أكبر تحسينات تم رصدها ضمن التجارب والإعدادات اللي الباحثون اختبروها.
ومن النتائج المثيرة للاهتمام إن Model أضعف مع Harness محسّن قدر في بعض التجارب يتفوق على Model أقوى باستخدام الـ Base Harness.
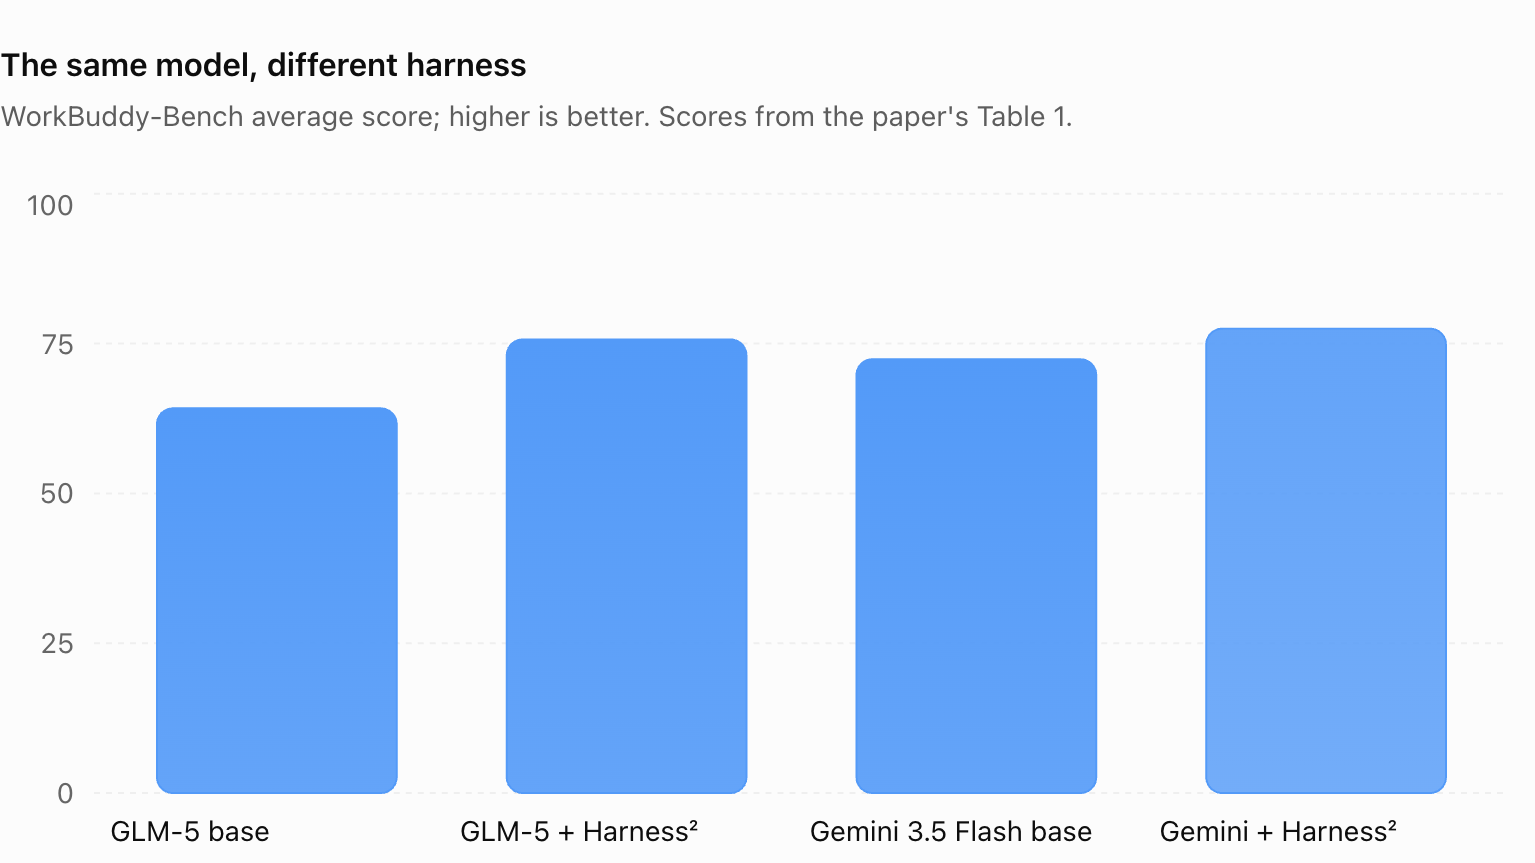
وده بيدعم الفكرة اللي بدأنا بيها:
مش دايمًا الحل إننا نستخدم Model أقوى. أحيانًا تحسين الـ Harness بيكون له تأثير أكبر من تغيير الـ Model نفسه.
الباحثون كمان عملوا Ablation Studies، وهي تجارب بيشيلوا فيها جزء من النظام علشان يعرفوا تأثيره.
ولاحظوا إن إزالة الـ Experience Library أو فصل التحسينات العامة عن المتخصصة أو مرحلة الـ Composition بتقلل الأداء في التجارب المعروضة.
وده بيدينا دليل إن أجزاء الـ Architecture بتساهم فعلًا في النتائج، مش مجرد إن النظام بيعيد المحاولة مرات أكتر.
هل نقدر نعتمد على Harness² في Production؟
لازم ناخد بالنا من شوية قيود مهمة.
أولًا: التكلفة
النظام بيشغّل نفس المهمة بأكثر من Harness، وبيستخدم مراحل إضافية للتحليل والتعديل والمقارنة.
وده معناه استهلاك أكبر للـ Tokens والـ Compute والوقت.
مش منطقي بالضرورة نستخدم نفس مستوى التحسين لكل Bug بسيط أو مهمة صغيرة.
ثانيًا: التحسن في السلوك مش ضمان لصحة النتيجة
ممكن الـ Agent يستخدم أدوات أفضل، ويعمل خطة منظمة، وفي الآخر يختار حل غلط.
البحث نفسه بيعرض حالات فشل في اختيار الـ Deliverables، وده بيأكد أهمية وجود Independent Evaluation وAcceptance Criteria كلما أمكن.
ثالثًا: الأمان والـ Isolation
الـ Repository بيذكر إن Network Access للـ Executors مش مقيّد بشكل افتراضي، وإن Codex Executor بيشتغل مع الـ Sandbox معطّل.
وده شيء لازم ناخده بجدية لو هنستخدم النظام مع Repositories حقيقية أو Credentials أو بيئات Production.
أي Agent مسموح له يغيّر Scripts أو Tools أو ينفّذ Commands محتاج حدود واضحة للصلاحيات وبيئة معزولة ووسائل مراجعة مناسبة.
رابعًا: مش كل تحسين يصلح لكل المهام
ممكن تعليمات مفيدة في مشروع معين تخلي الـ Agent أبطأ أو أقل دقة في مشروع تاني.
علشان كده الاحتفاظ بالسياق والأدلة المرتبطة بالتحسينات مهم بقدر الاحتفاظ بالتحسينات نفسها.
إيه اللي ممكن نتعلمه من Harness² كمطوّرين؟
بعيدًا عن استخدام الـ Framework نفسه، فيه مجموعة أفكار أعتقد إنها مفيدة جدًا لأي حد بيبني AI Development Workflows.
1. فكّر في الـ Agent كـ System كامل
متقيّمش جودة الـ Agent من اسم الـ Model بس.
راجع الـ Tools، والـ Context، والـ Skills، والـ Memory، وطريقة تنفيذ المهام.
ممكن تكون المشكلة في الـ Architecture المحيطة بالـ Model، مش في قدراته.
2. احتفظ بالـ Execution Evidence
بدل ما تكتفي بإن الـ Agent نجح أو فشل، حاول تفهم هو وصل للنتيجة إزاي.
هل استخدم الأدوات الصح؟ هل كرّر خطوات غير مفيدة؟ هل تجاهل معلومات مهمة؟
الـ Execution Traces ممكن تساعدك تحدد فرص تحسين عملية.
3. اختبر تغييرات الـ Harness
لو غيرت Prompt أو أضفت Skill، متفترضش إن الأداء اتحسّن لمجرد إن التعليمات الجديدة أوضح.
جرّب على مجموعة مهام ثابتة، وقارن النتائج والسلوك والتكلفة.
4. ابنِ Experience Library
لو بتستخدم Agents على مشاريع متعددة، ممكن تحتفظ بالدروس اللي اتعلمتها من كل مشروع.
مش مجرد Documentation للمشروع، لكن كمان إجراءات ثبت إنها ساعدت في حل أنواع معينة من المشاكل، مع الأدلة والسياق اللي بتوضح حدود استخدامها.
5. خلي الـ Improvement Process نفسه قابل للتطوير
بدل ما تفضل تعدّل الـ Prompts يدويًا بعد كل مشكلة، فكّر في Workflow يراجع الـ Agent Executions، ويقترح تحسينات، ويختبرها، وبعد كده يعرضها عليك للمراجعة.
مش لازم تبدأ بنظام كامل زي Harness². ممكن تبدأ بإجراء بسيط وتطوّره تدريجيًا.
هل مستقبل الـ AI Coding Agents في الـ Models ولا الـ Harnesses؟
في رأيي، واحد من أهم الأسئلة اللي البحث ده بيفتحها هو شكل الـ Development Workflow في المستقبل.
إحنا حاليًا بنقضي وقت كبير في تجهيز بيئة الـ Agent، وشرح الـ Codebase، وتحديد التعليمات، ومراجعة النتائج.
لكن ماذا لو قدرنا نبني نظام بيتعلم من كل Ticket بيشتغل عليها؟
نظام يعرف إن نوع معين من المشاكل بيحتاج Logs معينة، وإن مشروع آخر بيحتاج Tests قبل أي تعديل، وإن Tool معينة بتفشل في ظروف محددة.
ومع الوقت، بدل ما نفضل نبدأ كل مهمة تقريبًا من الصفر، النظام يبقى عنده خبرة متراكمة في تنفيذ المهام وتحسين طريقة تنفيذها.
طبعًا ده مش معناه إننا وصلنا لـ Agents قادرة تطوّر نفسها باستقلال كامل، أو إننا نقدر نستغنى عن الـ Human Review.
لكن Harness² بيقدم محاولة بحثية مهمة لربط ثلاث أفكار ببعض:
Execution → Evidence-Based Improvement → Persistent Learning
ومن وجهة نظري، ده اتجاه يستحق المتابعة والتجربة، خصوصًا لأي مهندس بيشتغل على Agent Orchestration أو بيحاول يبني Automated Development Workflows.
لأن السؤال مش بس:
إزاي نخلي الـ AI Agent يكتب كود أحسن؟
السؤال الأهم يمكن يكون:
إزاي نبني نظام بيتعلم من طريقة شغله، ويعرف يحسّن نفسه من غير ما نضطر نعيد تصميم الـ Workflow يدويًا مع كل مهمة؟
وده بالضبط السؤال اللي بيخلي Harness² بحث مثير للاهتمام.
المصادر
المقال مبني على قراءة البحث والـ Repository الرسمي. الأمثلة المرتبطة بالمتجر الإلكتروني، والتطبيقات الهندسية المقترحة، هي أمثلة توضيحية وتحليلات شخصية وليست نتائج تجارب منشورة من الباحثين.